BlogKI im Browser
LLM im Browser: Ein Modell zieht in den Tab

Worum es geht
- Was leistet ein Sprachmodell, das direkt im Browser-Tab läuft?
- Wer liefert das Modell, und wer behält den Überblick über die Daten?
- Wann genügt das kleine Modell, das ohnehin schon auf dem Gerät liegt?
Eine Website musste bisher einen Server fragen, sobald sie etwas wissen sollte. Diese Selbstverständlichkeit beginnt gerade zu verschwinden.
KI im Browser: Der Tab wird zur Rechenumgebung
Ursprünglich war der Browser ein Anzeigewerkzeug für HTML und Bilder, nicht mehr. Mit JavaScript wurde er interaktiv, mit WebAssembly konnte er kompilierten Code in nahezu nativer Geschwindigkeit ausführen, mit WebGL und inzwischen WebGPU sogar komplexe Grafik direkt auf der GPU berechnen. Jede dieser Erweiterungen verschob eine Aufgabe, die vorher dem Server vorbehalten war, in den Tab hinein. Was mit Dokumenten begann, wurde über Anwendungen zur Plattform, und diese Plattform bekommt gerade eine neue Fähigkeit hinzu: Sie kann selbst schlussfolgern, formulieren und einordnen.
Den Ausschlag gibt ausgerechnet die Grafikschnittstelle. WebGPU gibt JavaScript direkten Zugriff auf die parallele Rechenleistung der Grafikkarte, genau jene Art von Rechenleistung, die ein Sprachmodell für seine Matrizenmultiplikationen braucht. Ohne diesen Zugriff bliebe lokale Inferenz eine Frage reiner CPU-Geduld. Mit ihm wird aus einem Browser-Tab eine Laufzeitumgebung für Modelle, die bis vor kurzem ausschließlich in Rechenzentren liefen.
Der Browser war Dokumentenleser, dann Anwendungsumgebung, nun wird er zur Rechenumgebung für Modelle. Für Websites, die bisher jede Frage nach draußen reichen mussten, ändert das die Architektur.
Kontext: Was ein lokales Sprachmodell im Browser sieht
Wer sich ein lokales Sprachmodell im Browser vorstellt, unterstellt ihm gern eine Fähigkeit, die es gar nicht hat: dass es sehe, was die Nutzerin gerade sieht. Tatsächlich bekommt ein Modell nur den Text, den eine Anwendung ihm aktiv übergibt, sei es ein markierter Absatz, ein Formularfeld oder ein Datensatz. Ohne diese Übergabe bleibt das Fenster leer.
Diese Einschränkung wirkt zunächst wie ein Nachteil und ist tatsächlich ein Vorzug. Weil die Anwendung entscheidet, welchen Ausschnitt sie zeigt, entscheidet sie zugleich, was das Modell überhaupt wissen darf. Ein Sprachmodell im Tab ist nie neugierig auf eigene Faust. Es bekommt exakt das, was eine Entwicklerin ihm vorlegt. Kontext ist Berechtigung: Was eine Anwendung dem Modell zeigt, markiert zugleich die Grenze dessen, was sie ihm erlaubt.
Wie das aussehen kann, zeigt eine Fachgesellschaft, die alljährlich Hunderte Abstracts für ihren Jahreskongress sammelt. Ein lokales Modell könnte jeden eingereichten Text direkt im Formular auf fehlende Pflichtangaben prüfen und passende Schlagworte vorschlagen, bevor die Einreichung überhaupt abgeschickt wird. Weder der Text noch der Name der einreichenden Person müsste dafür einen externen KI-Dienst erreichen. Das Modell bekäme genau ein Feld zu sehen, nicht die Anmeldedaten, nicht die übrige Website, nicht die Historie vergangener Kongresse.
Built-in AI oder Bring Your Own AI: Wer liefert das Modell?
Für die Inferenz im Browser haben sich zwei Wege etabliert, die sich in drei Fragen auseinanderlegen lassen: Wer liefert das Modell? Wer kontrolliert die Laufzeitumgebung? Und wer kann nachvollziehen, welchen Datenweg eine Eingabe nimmt?
Beim ersten Weg, Built-in AI, bringt der Browser Modell und Laufzeit gleich mit. Chrome stellt dafür eine Prompt APIbereit, über die Websites das im Browser hinterlegte Modell Gemini Nano ansprechen können, ohne selbst ein einziges Megabyte an Gewichten herunterzuladen (1). Voraussetzung ist allerdings einiges an Hardware: mindestens 22 Gigabyte freier Speicherplatz für den einmaligen Download, dazu eine Grafikkarte mit mehr als vier Gigabyte VRAM oder alternativ 16 Gigabyte Arbeitsspeicher und vier Prozessorkerne. Die Anwendung muss sich dabei auf Architektur und Dokumentation des Browserherstellers verlassen. Wie das Modell im Detail arbeitet, welche Version gerade läuft und was mit den Eingaben geschieht, entscheidet nicht sie.
An diesem Punkt zeigte sich in diesem Jahr, wie brüchig solches Vertrauen sein kann. Bis Chrome 147 beschrieben die Einstellungen die On-Device-KI mit dem Zusatz, die Modelle liefen ohne Datenübermittlung an Google-Server. Mit Version 148 verschwand exakt diese Formulierung, was Datenschutzkritiker aufhorchen ließ. Google erklärte, an der Verarbeitung habe sich nichts geändert, die Änderung solle Missverständnisse vermeiden (2). Ob das stimmt, lässt sich von außen kaum prüfen, und genau darin liegt der Punkt. Selbst wenn die Berechnung auf dem Gerät bleibt, sieht die Website, die das Modell anspricht, Eingabe und Antwort ohnehin.
Beim zweiten Weg, Bring Your Own AI, bringt die Anwendung selbst Modell und Laufzeit mit. Das Projekt WebLLMführt Sprachmodelle über WebGPU direkt im Browser aus und kann die Modelldateien lokal zwischenspeichern (3). ONNX Runtime Web von Microsoft folgt demselben Grundprinzip und führt Modelle aus Frameworks wie PyTorch oder TensorFlow aus, vom Sprachmodell bis zum Klassifikator (4). Der Preis dafür ist mehr Entwicklungsaufwand. Der Gewinn ist Kontrolle: Wer selbst festlegt, welche Datei geladen wird, wann ein Netzwerkaufruf stattfindet und welche Daten eine Anwendung überhaupt verlassen, kann diesen Weg auch nachprüfen, Zeile für Zeile.
„Lokal" beschreibt zunächst nur den Ort der Berechnung. Wer wissen will, ob Daten tatsächlich lokal bleiben, muss auch den Weg dorthin kontrollieren können.
Grenzen lokaler KI: Download, Hardware, Modellgröße
Ein Modell, das im Tab läuft, verursacht trotzdem Kosten, sie wandern nur vom Rechenzentrum auf das Gerät der Nutzerin. Der erste Preis ist der Download: Wer die genannten 22 Gigabyte nicht frei hat oder über eine schwache Mobilfunkverbindung online ist, wartet unter Umständen mehrere Minuten, bevor überhaupt die erste Antwort möglich wird. Der zweite Preis ist Arbeits- und Grafikspeicher: Modellgewichte und Kontextfenster müssen während der gesamten Sitzung geladen bleiben, auf einem Smartphone eine andere Größenordnung als auf einer Workstation. Hinzu kommen Energieverbrauch und die Frage, ob die Hardware der Besucherin die Anforderungen überhaupt erfüllt.
Aus diesen Kosten folgt fast automatisch ein kleineres Modell, und ein kleineres Modell kommt mit einem knapperen Kontextfenster, weil Kontext zusätzlichen Speicher belegt. Das klingt nach einem Abstieg, obschon es das nicht zwangsläufig ist. Ein kleines Modell, das exakt eine Aufgabe in einem definierten Kontext erledigt, ist nicht die minderwertige Version eines Cloudmodells, sondern anders zugeschnitten.
Wofür ein Frontier-Modell mit enormer Reserve entwickelt wird, allgemeine Kompetenz über beliebige Themen, braucht ein Formular-Assistent nicht. Er muss ein Feld lesen, eine Regel anwenden, einen Vorschlag formulieren. Dafür reicht ein Modell, das nur einen Bruchteil der Parameter besitzt. Wer es dagegen als Alleswisser einsetzt, erntet Halluzinationen.
Datenschutz, Offlinebetrieb, Kosten: Der Datenweg entscheidet
Was lokale Modelle verändern, zeigt sich weniger in der Ladezeit als im Datenweg. Am deutlichsten beim Datenschutz: Lokale Verarbeitung kann bedeuten, dass eine Eingabe das Gerät nie verlässt. Garantiert ist das nur dort, wo die Anwendung selbst kontrolliert, welche Netzwerkaufrufe passieren.
Für eine medizinische Fachgesellschaft oder einen Berufsverband ist das mehr als eine technische Fußnote. Anonymisierte Fallbeschreibungen, unveröffentlichte Studienergebnisse oder interne Mitgliederkorrespondenz in ein Formularfeld einzugeben, das lokal ausgewertet wird, ist eine andere Risikolage, als wenn dieselbe Eingabe wie bei Schatten-KI im Konto eines fremden Dienstes landet, dessen Verarbeitungsbedingungen sich morgen ändern können. Dieselbe Frage stellt sich beim eigenen Server: Entscheidend ist weniger der Standort als die Verfügungsgewalt über die Daten.
Hinzu kommen drei praktische Folgen. Ein einmal geladenes Modell arbeitet im Offlinebetrieb unabhängig von der eigenen Serverinfrastruktur weiter, etwa auf einem Kongress mit überlastetem WLAN. Ohne Weg zu einem entfernten Rechenzentrum sinkt die Latenz, solange die Hardware mitspielt. Und jede Anfrage an ein Cloud-Sprachmodell erzeugt laufende Tokenkosten, die sich mit der Nutzung summieren, während eine lokal ausgeführte Funktion nach dem Download keine variablen Inferenzkosten mehr verursacht. Für ein kleines Feature, das tausendfach am Tag läuft, etwa eine automatische Zusammenfassung oder ein Textvorschlag, kann dieser Unterschied über die Betriebszeit erheblich sein.
Der Abstract-Assistent der Fachgesellschaft ist deshalb interessant, weil er Datenschutz, Offlinefähigkeit und Kosten in einer einzigen architektonischen Entscheidung bündelt.
Cloud oder lokal: Wie viel Intelligenz braucht eine Anwendung?
Je kleiner und spezialisierter ein Modell wird, desto mehr von dem, was landläufig als Intelligenz einer Anwendung gilt, übernehmen Kontext, Regeln und die Softwarearchitektur um das Modell herum: eine Verschiebung vom Prompt zum System, die im Browser eine sehr physische Dimension bekommt, weil die Grenze zwischen Modell und Struktur hier zugleich eine Grenze zwischen Tab und Rechenzentrum ist.
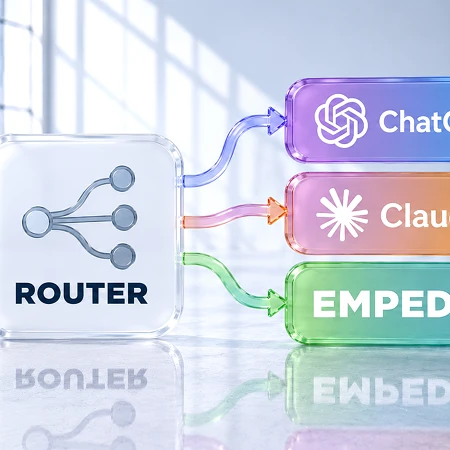
Daraus ergibt sich eine Arbeitsteilung, die sich schon heute entwickeln lässt: Das kleine Modell im Browser erledigt das Routinierte, das große in der Cloud das Schwierige. Ein Router entscheidet je Anfrage, wer antwortet, wie es das Modell-Routing mit dem Ziel niedrigerer Tokenkosten beschreibt, und er kann dabei auch nach Datensensibilität unterscheiden.
Die naheliegende Prognose lautet, Cloud-Modelle würden immer größer und lokale immer kleiner bleiben. Wahrscheinlicher verschiebt sich die Frage von der Kapazität eines Modells zum tatsächlichen Bedarf einer Aufgabe. Das leistungsfähigste Modell steht weiterhin im Rechenzentrum. Für vieles genügt das Modell, das schon da ist.
Quellen
- Chrome for Developers: The Prompt API (2026)
- Computing: Google removes 'no data sent' claim from Chrome AI settings (2026)
- WebLLM (MLC Community): Advanced Use Cases
- Microsoft: ONNX Runtime Web